Dulu untuk merancang template kita harus menyimpan file-file gambar dalam sebuah folder, file coding dalam sebuah forder, dan ada beberapa file coding dengan nama-nama yang berbeda. kemudian sejak semantic web lahir dalam satu file coding kita bisa menyimpan template dan data sekaligus di file yang sama dalam bentuk metadata, jadi lebih simple dan lebih ringan.
WHAT'S NEW?
Loading...
Crawl / Crawling mempunyai arti "Merangkak". Crawl menyimpan anotasi dalam Knowledge Graph. Sistem Web Crawler adalah sistem yang mengelilingi tempat penyimpanan data di internet dan dikumpulkan kedalam database untuk pengaturan lebih lanjut untuk dianalisis.
Dalam proposal Thesis nya Kancherla mendefinisikan Web Crawler adalah sejenis bot yang berjalan pada internet untuk mengumpulkan data dan menyimpan ke database untuk dianalisis dan diatur lebih lanjut. Proses Web Crawler meliputi menemukan halaman web dan mengatur sedemikian rupa sehingga mesin pencari dapat mengambil yang efisien.
Smart Crawler berdasarkan konsep Semantic Search Engine untuk menjelajah internet pada proposal ini dijelaskan untuk mengumpulkan halaman web dan menyimpannya dalam bentuk file teks. hal ini berdasarkan konsep Semantic Search Engine akan mengambil input hanya dalam bentuk file teks. untuk meningkatkan efisiensi engine Smart Crawler memfilter teks sebelum menyimpannya. Selain Filtering, Smart Crawler melewat (skip) crawling URL untuk file seperti file gambar atau file multimedia yang berisi data Non-tektual. Smart Crawler juga efektif mengelola dan menyimpan metadata dengan sistematis.
Karakteristik Fitur Crawlers
Crawler yang merangkak di internet harus memiliki fitur dasar berikut sehingga terlayani tujuan mereka, kesejahteraan server yang menyimpan data dan juga web secara keseluruhan.
1. Kekokohan (Robustness)
Web berisi loop disebut Spider Traps (Laba-laba Perangkah). yang dimaksud untuk menyesatkan Rekursif Crawler pada domain tertentu dan tertancap dalam satu domain tunggal. Mereka menghasilkan infinite loop halaman web yang mengarah kemana-mana. Crawler harus tahan terhadap perangkap tertentu. perangkap ini mungkin tidak selalu dirancang untuk menyesatkan crawler tetapi mungkin hasil dari pengembangan web rusak.
2. Kesopanan (Politeness)
Server memiliki kebijakan mengatur ketika crawler mengunjungi mereka. kebijakan kesopanan ini harus dihormati. Sebuah server awalnya dirancang untuk melayani. Menghalagi server dapat menyebabkan pemblokiran crawler oleh server. jadi lebih baik menghormati kebijakan server.
3. Distributed
Crawler harus dapat berfungsi dalam model distribusi. itu bisa memberikan beberapa gambaran untuk dirinya sendiri bekerja secara paralel dalam koordinasi yang tepat untuk menjelajah internet secepat mungkin.
4. Terukur (Scalable)
Crawler harus terukur. Harus punya fleksibelitas untuk menambah mesin-mesin baru dan bandwith ekstra bila dibutuhkan.
5. Kinerja dan Efisiensi (Performance and Eficiency)
Penggunaan resource seperti kekuatan pemrosesan, bandwidth jaringan dan penyimpanan harus bijaksana. Faktor-faktor adalah penentuan seberapa efisien crawler.
6. Kualitas
Crawler harus dapat membedakan antara informasi yang berguna dan informasi yang tidak berguna. Server terutama melayani permintaan lain yang banyak mengandung informas yang mungkin tidak berguna. Crawler harus menyaring konten ini.
7. Kesegaran (Freshness)
Dalam banyak situasi. Crawler perlu mengcrawl kehalaman yang sama lagi untuk mendapatkan konten baru dari halaman lama. untuk alasan ini, crawler harus dapat mengcrawl halaman yang sama pada tingkat yang kurang lebih sama dengan laju perubahan informasi pada halaman. dengan demikian, crawler akan dapat memastikan bahwa konsep pada mesin pencari adalah terbaru dan relevan dengan konteks kekinian.
8. Extensible
Crawler harus dapat beradaptasi dengan meningkatnya jumlah format data yang akan ditemui pada situs web. hal ini juga perlu diadaptasi dengan protokol baru yang digunakan pada beberap server.
Tipe dari Web Crawler Secara Umum di Klasifikasikan Kedalam 4 Tipe :
1. Fokus Crawler
Fokus Crawler adalah Web Crawler yang mendowload halaman yang berhubungan untuk topik tertentu yang diminati. mengumpulkan dokumen yang fokus dan relevan pada topik tertentu. dari caranya berkerja sering di sebut Topik Crawler. Fokus Crawler menentukan halaman yang relevan sebelum melakukan crawling halaman web. Mengestimasi halaman yang diberikan untuk topik tertentu dan bagaimana memproses. Keuntungan utama dari Focus Crawler adalah membutuhkan hardware dan resource network yang kecil dan biaya kecil. dan juga terus melakukan cek pada lalulintas jaringan (traffic network).
2. Traditional Crawler
Tradisional Crawler secara berkala mengcrawler URL yang telah di Crawling dan mengganti dokumen lama dengan dokumen baru untuk menyegarkan koleksinya. Sebaliknya, sebuah crawler tambahan merefresh secara bertahap koleksi yang telah ada dari halaman web yang telah sering dikunjungi. hal ini berdasarkan estimasi rating (tingkat) seberapa sering sebuah halaman web itu diubah. Hal ini juga menggantikan halaman lama dan kurang penting dengan halaman baru yang lebih relevan. ini memecahkan masalah fresness of data (kesegaran data). Keuntungan dari Traditional Crawler adalah data yang disedikan hanya bernilai untuk user. menghemat bandwith jaringan dan mencapai pengayaan data.
3. Distributed Crawler
Teknik komputasi terdistribusi adalah fondasi utama untuk mengcrawler web yang didistribusikan. Banyak crawler bekerja pada waktu yang sama ditandem dan mendistribusikan beban kerja mengcrawler web untuk mendapatkan cakupan maksimum dari internet. Pusat server mengelola komunikasi, singkronisasi node dan berkomunikasi antara bot yang berbeda. hal ini juga secara geografis didistribusikan. hal ini juga didistribusikan secara geografis. ini terutama menggunakan Page Rank Algorithm (Algoritma Peringkat Halaman) untuk meningkatkan efisiensi dan kualitas pencarian. keuntungan dari Crawler Web Terdistribusi adalah Kokoh (Robust). hal ini tahan terhadap sistem crash dan lainnya. dan dapat diadopsi untuk berbagai kebutuhan Crawler.
4. Paralel Crawler
Paralel Crawler adalah beberapa crawler berjalan pada waktu yang sama. Hal ini terdiri dari beberapa proses crawling disebut sebagai C-Procs yang dapat berjalan pada jaringan workstation. crawler paralel tergantung pada pilihan halaman dan freshness page (kesegaran halaman). sebuah crawler paralel dapat didistribusikan di lokasi geografis jauh atau berada pada jaringan lokal. Paralelisasi sistem mengcrawler sangat penting dari sudut pandang download dokumen dalam jumlah waktu yang wajar.
Salah satu bahasa pemrograman yang digunakan untuk mengcoding sebuah Web Crawler adalah Python, karena Python memiliki fitur yang sederhana, portable, free dan open source.
Source :
Kancherla, Vinay, 2014, A Smart Web Crawler For Concept Based Semantic Search Enggine, Sanjos State University.
http://www.slideshare.net/iosrjce/smart-crawler-a-two-stage-crawler-for-concept-based-semantic-search-engine?from_action=save
http://www.slideshare.net/icaromedeiros/linked-data-in-use-front-in-bahia-2014?qid=4e72a7b5-65c6-416f-abb8-38f477849d37&v=&b=&from_search=17
Pemanfaatan Pada Blog :
Pemanfaatan RDFa pada Goverment Data adalah sebagai berikut :
Blog adalah tempat entry item untuk di jual, entry yang di review, entry yang merupakan spesialisasi informasi tertentu, halaman web ingin menjadi data. dengan menggunakan RDFa mempublis data menjadi mudah dengan HTML. Sebuah halaman blog atau web akan lebih mudah terindek oleh search enggine.
Pemanfaatan Pada Simbol Kimia :
- Membuat spesifik Chemistry untuk search enggine
- Memperbaiki UserInterface untuk blog
Pemanfaatan RDFa Penggunaan RDFa untuk Organisasi /Individu adalah sebagai berikut :
- Vertical Search Enggine
- Mempermudah organisasi untuk mempublish data
- Mempermudah individu untuk mempublish data
- Menyesuaikan User Interface dengan menggabungkan link data cloud.
Pemanfaatan RDFa pada Goverment Data adalah sebagai berikut :
- Menghilangkan ambiguitas pada halaman data
- Mempermudah untuk publish data
- Cukup powerful untuk mempublish link data
- Ideal untuk publish goverment data
Pemanfaatan RDFa pada SEO (Search Enggine Optimization) adalah untuk memperbaiki akurasi identifikasi bantuan pencarian example : Bukan hanya untuk 'Mentri Kelautan dan Perikanan' tetapi juga 'Pudji Astuti'.
Source :
http://www.slideshare.net/mark.birbeck/the-possibilities-of-rdfa-and-the-semantic-web/50
http://www.slideshare.net/mark.birbeck/rdfa-in-seo?related=1
Secara Sederhana RDFa (RDF in Attribute) adalah Serialisasi RDF secara umum yang embbedded di HTML, XHTML dan XML.
Didalam wikipedia.org RDFa (RDF in atribute) didefenisikan sebagai Rekomendasi dari W3C untuk menambahkan sekumpulan attribut ke HTML, XHTML dan berbagai jenis dokumen XML untuk embbedding metadata yang kaya pada dokumen web. RDFa merupakan pemetaan model data yang memungkinkan pengguna untuk embbedded ekspersi triple RDF dalam dokumen XHTML. Hal ini juga memungkinkan ekstraksi model triple RDF sesuai yang digunakan agent.
RDFa (RDF in attribute) merupakan RDF yang bisa disisipkan dalam dokumen
(X)HTML. RDFa juga sudah menjadi spesifikasi resmi W3C. RDFa merupakan salah satu format metadata dalam dokumen HTML, merupakan standar dari W3C yang paling bisa diperluas. didalam dokumen lain RDFa (RDF in attribute) didefinisikan sebagai attribute kata atau frasa yang harus menangani entitas semantik.
RDFa (RDF in attribute) adalah perluasan untuk HTML5 yang akan membantu anda markup sesuatu seperti People, Place, Tempat, Resep dan Description. Search Enggine dan Web Services menggunakan markup ini untuk menghasilkan daftar pencarian yang lebih baik dan memberikan visibilitas yang lebih baik di Web, sehingga orang dapat menemukan website anda dengan lebih mudah.
Contoh sederhana dari RDFa adalah :
<html xmlns="http://www.w3.org/1999/xhtml" prefix="foaf: http://xmlns.com/foaf/0.1/ dc: http://purl.org/dc/terms/" > <head> <title>My home-page</title> <meta property="dc:creator" content="Mark Birbeck" /> <link rel="foaf:topic" href="http://www.example.com/#us" /> </head> <body>...</body> </html>
RDFa melakukan pemetaan untuk Dokumen RDF seperti yang terlihat pada gambar berikut :
Penggunaan RDFa yaitu untuk :
- Transfer data dari suatu aplikasi untuk aplikasi lain melalui web.
- Menulis data hanya sekali untuk user web dan aplikasi web
Langkah - langkah pada RDFa :
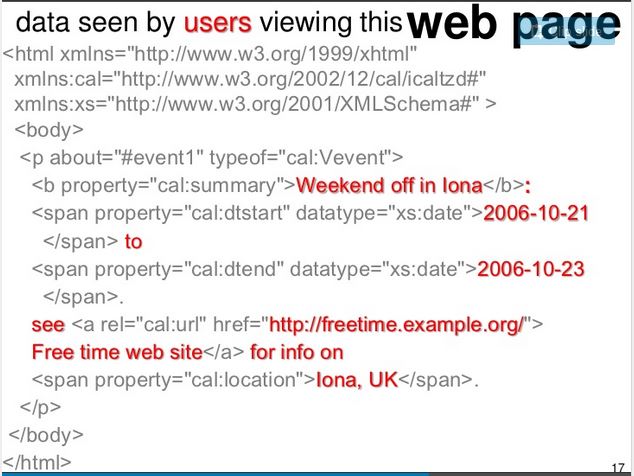
Data yang terlihat oleh User :
Code data yang terlihat oleh User pada Website :
Code RDFa Agent Pada Sebuah Website :
Yang diketahui RDFa Agent pada sebuah defenisi code RDFa pada sebuah website :
Hal yang harus diketahui untuk RDFa adalah :
- Mendeklarasikan schemas yang anda gunakan.
- Menggunakan attribut untuk mark (menandai), type dan add data.
- Membiarkan RDFa agent untuk mengekstrak RDF dari dokumen.
Data yang terlihat oleh User :
Code data yang terlihat oleh User pada Website :
Code RDFa Agent Pada Sebuah Website :
Yang diketahui RDFa Agent pada sebuah defenisi code RDFa pada sebuah website :
Hal yang harus diketahui untuk RDFa adalah :
- RDFa merupakan attribut yang mempunyai arti untuk mesin
- RDFa embedded dalam dokumen HTML dan yang secara langsung tidak terlihat oleh User
- Embedded data dibutuhkan untuk menghilangkan ambiguitas pada content dalam hal web.
- RDFa Developer merupakan Plugin Mozilla Firefox yang dapat melakukan :
- Pemeriksaan terhadap markup RDFa
- Mengizinkan query data pada halaman web menggunakan bahasa query SPARQL
- Mendeteksi perangkap umum pada penggunaan RDFa
Hubungan RDFa dengan Semantic Web secara keseluruhan adalah pada Link Data, Semantic Web Stack, OWL (Web Ontology Language) yang mampu menambahkan kosa kata yang panjang untuk semantik formal dan ekstensi dari RDF ke RDFS (RDF-Schema), Triple Store (A database for RDF), SPARQL yang merupakan bahasa query untuk RDF.
Contoh Website yang saat ini Menggunakan RDFa adalah :
Bagian yang dilingkari warna merah merupakan contoh sintaks untuk RDFa pada metadata buku di Oreilly.com :
Fungsi Sintaks Pada RDFa adalah sebagai berikut :
Summary untuk RDFa adalah sebagai berikut :
- RDFa menyediakan tags semantic yang embedded didalam halaman web.
- RDFa membantu software untuk mengerti content dari halaman web.
- RDFa related dengan RDF, yang mana RDF merupakan standar untuk sharing data sehingga dipahami oleh mesin.
- Penggunaan RDFa tools seperti RDFaDev, checkrdfa.info, GRDDL Services, HTML Editor.
- RDFa adalah stepping stone (batu loncatan) untuk kemampuan penuh Semantic Web.
- BBC, BestBuy dan Orielly yang awal menerapkan RDFa.
Manfaat RDFa adalah sebagai berikut :
- RDFa memberikan kemudahan untuk mempublish data RDF di web.
- Seringnya, data RDF yang sama tersedia dalam format yang berbeda, memasukkan RDFa
- Terserah klien untuk memilih yang mana digunakan
- Aplikasi Web bergantung pada RDFa,
3. Bermacam search enggine mulai menggunakan mengkonsumsi RDFa seperti Google dan Yahoo
4. Facebook 'Sosial Graph' based on RDFa
5. Efek dari google banyak website yang menggunakan format RDFa, seperti :
- Tesco, NewsWeek, Slide Share, The London Gazzete dan White House.
- BestBuy & Orielly Catalog
6. Manfaat yang dirasakan Bestbuy setelah menggunakan RDFa adalah pengingkatan trafik pada websitenya sebesar 30%.
7. Mempublis RDFa merupakan langkah penting untuk menggabungkan Semantic Web dan Traditional Web.
Source :
https://www.w3.org/TR/2015/REC-rdfa-core-20150317/#rdfa-attributes
https://en.wikipedia.org/wiki/RDF
http://www.paradesain.net/547/mengenal-semantic-webweb-semantik/
https://rdfa.info/
http://www.slideshare.net/shamod/rdfa-what-why-and-how-by-mike-hewett-and-shamod-lacoul
http://www.slideshare.net/fabien_gandon/rdfa-in-a-nutshell-v1?related=5
Schema.org adalah
Untuk menganotasikan sebuah Website atau Blog dengan struktur kode schema.org, yang pertama harus kita lakukan adalah mengubah dan menambah kode pada file template, contoh disini saya gunakan file template untuk blogspot yang berformat .XML, prosesnya sangat sederhana mari ikuti step by step seperti berikut :
- Masuk ke Dashboard Blogspot (http://blogger.com)
- Pilih Bagian Template > Edit HTML > Saat melakukan pengeditan sebaiknya file template asli di save dulu dalam bentuk nama lain di notepad, sehingga saat terjadi kesalahan atau kegagalan dalam pengkodingan anda ada backup data file templatenya.
- Proses Pengeditan awal bisa dilihat dan dipelajari di Website ini, dan penambahan sedikit kode seperti ini :
- Setelah dilakukan pengeditan kode > Simpan Template > Kembali
- Anda bisa me refres alamat website anda contoh disini : http://semanticca.blogspot.com/
- kemudian klik kanan > View Page Source > Select All > Copy > Pastekan di Google Developer Testing Tools
- Kalau masih ada yang salah monggo silahkan di cek untuk codingnya supaya jangan ada yang kurang. dan langkah tersebut diulang terus menerus sampai menemukan hasil seperti yang saya paparkan.
Website Semantic CA sebelum dianotasikan dengan kode-kode schema.org :
Pada gambar di atas hasil dari parsing Page Source menggunakan Google Developer Testing Tools , Hanya menghasilkan dua item yaitu Hatom dan Hasil Penelusuran Khusus. kemudian setelah saya menambah sedikit code script berikut yang letak sebelum </head> dan setelah <body...> :
Dan hasil yang didapat setelah dilakukan parsing dari code view page sourcenya dengan Google Developer Testing Tools adalah sebagai berikut :
Waaala.... Itulah hasil setelah dilakukan sedikit perubahan codingnya, Tambah Dua Item lagi yaitu WebPage yang terdiri dari data Name, Description dan Author dan Item untuk SiteNavigationElement.
Dan hari ini Blog Semantic CA sudah teranotasi dengan sturktur file Schema.org.
Happy Coding... ^_^
Menurut Gruber dan Brost yang dijelaskan oleh Studer dan rekan pada tahun 1998, Ontology secara formal adalah spesifikasi eksplisit dari konseptualisasi bersama (shared). Konseptualisasai mengacu pada model abstrak dari beberapa fenomena di dunia dengan memiliki identifikasi konsep yang relevan dari fenomena itu. Eksplisit berarti jenis konsep yang digunakan dan kendala pada penggunaan secara eksplisit didefinisikan. Formal mengacu pada fakta bahwa ontologi harus bisa dibaca mesin. Bersama (share) disini mencerminkan gagasan bahwa ontologi menangkap pengetahuan konseptual yaitu tidak secara private untuk beberapa individual, tetapi diterima oleh kelompok. Gruber mengidentifikasi lima jenis komponen yaitu : Class, Relations, Function, Formal Axioms dan Instances.
Ontologi harus dinyatakan dalam notasi nyata. Beberapa komponen untuk membangun ontology adalah XML (eXtensible Marup Language),RDF (Resource Description Framework), RDFS (Resource Description Framework Schema) dan OWL (Web Ontology Language). SPARQL adalah bahasa query untuk RDF. XML adalah dasar dari bahasa ontologi. Bahasa ontologi disimpan dalam bentuk XML. Bahasa Ontology yang paling sering digunakan adalah OWL dan RDFS.
Menurut Witrut Kessler didalam slide presentasinya didefinisikan bahwa, Pencarian Semantic (Semantic Search) adalah Proses akses informasi, dimana satu atau beberapa aktifitas dapat mendukung dengan sekumpulan kemampuan fungsionalitas dengan teknologi semantik.
- Fungsionalitas Search Enggine : Query Construction (Membangun Query), Query Processing, result presentation.
- Teknologi Semantik : Knowledge Extraction, Knowledge Representation, Reasoning.
Semantic Search dengan Keyword Index :
- Entry dalam kamus adalah keyword (Seperti traditional information retrieval (Pengambilan informasi tradisional))
- Memiliki ontology
- Pemetaan keyword (keyword map) untuk elemen pada ontology
- Ontology digunakan untuk ketidak ambiguan query, misalnya untuk memperoleh arti kata yang tepat dan perluasan query.
- Hasilnya, Konsep di petakan dan dokumen yang mengandung keyword dikembalikan.
Contoh Penerapan Pencarian Semantik yang dilakukan oleh Google yaitu Google menerapkan Algoritma Google Hummingbird yaitu sebuah Algoritma yang memperhatikan setiap kata dalam query dan memperhitungkan semua kata pada kalimat. tujuannya agar halaman yang memuat kalimat dalam pencarian ditampilkan dengan akurat. Misalnya dengan pertanyaan "Siapa presiden indonesia tahun 2015 " maka google akan memberikan jawaban yang tepat untuk pertanyaan ini serta dengan link-link terkait tentang presiden indonesia tahun 2015, seperti gambar dibawah ini :
Source :
http://creativecommons.org/licenses/by-nc-sa/3.0/